Výběr dat
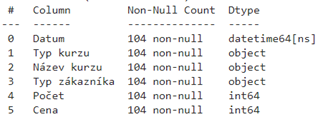
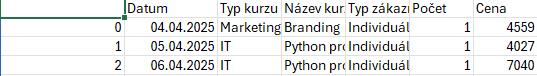
Uvažujme proměnnou s názvem df, ve které budou uloženy data z Excelu se sloupci datum, typ kurzu, název kurzu, typ zákazníka, počet a cena, na kterých se bude provádět výběr dat. Základní charakteristika dat je následující: df = xl(„A1:F105“, headers=True) df.info()
Výběr sloupců
Sekce “Výběr sloupců”Praktické vysvětlení
Sekce “Praktické vysvětlení”2 způsobu výběru jednoho sloupce z dataframe:
Df[‚column_name‘] – Výběr jednoho sloupce se provádí vypsáním názvu sloupce v textovém formátu („“) do hranatých závorek (listu). Výstupem bude series.
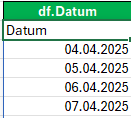
Df.column_name – Druhý způsob je vypsání za tečku název sloupce, který má být zobrazen. Výstupem bude series.
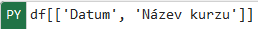
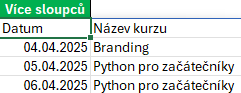
Pokud je potřebné vybrat více sloupců z dataframe, lze je vybrat pouze prvním způsobem zadáním sloupců do listu, které jsou oddělený čárkou. Navíc je nutné referencovat list dvojitým listem [[]]. Výstupem bude nový dataframe.
Df[[‚column_name1‘, ‚column_name2, … column_nameN]] – Vybrání více sloupců z dataframe.
Argumenty
Sekce “Argumenty”Column_name (str, povinný) – název sloupce z dataframe.
[‚column_name1‘, ‚column_name2, … column_nameN] (list of str) – seznam názvů sloupců, které mají být vybrány.
Použití
Sekce “Použití”Df[‚Datum‘] – výběr sloupce „datum“ z dataframe prvním způsobem.
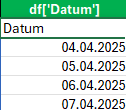
Df.Datum – výběr sloupce „datum“ z dataframe 2. způsobem.
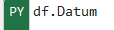
df[[‚Datum‘, ‚Název kurzu‘]] – vybrání sloupce „datum“ a „Název kurzu“ z dataframe.
Loc[]
Sekce “Loc[]”Definice
Sekce “Definice”Funkce vybere řádky a sloupce pomocí názvů (label-base selection) z dataframe. Pokud je nutné vybrat řádky a sloupce indexy, existuje funkce iloc.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Je možné zadat pouze vybrání řádku, více řádků, sloupce, více sloupců, nebo i sloupce a řádky či více řádků a sloupců najednou.
Pokud je nutné vybrat pouze jeden řádek a všechny sloupce, argument sloupců může být prázdný. Pokud je potřebné vybrat jeden sloupce, ale všechny řádky, je nutné zadat argument řádků.
Argumenty
Sekce “Argumenty”index (int, str, slice nebo list) – Názvy řádků (indexy), které mají být vybrány
row_name, column_name (volitelné) – Kombinovaný výběr jak řádků, tak i sloupců.
Použití
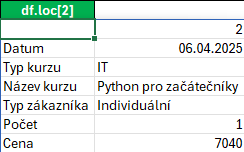
Sekce “Použití”Df.loc[2] – výběr řádku s indexem 2 (třetího řádku, jelikož je indexováno od 0) pro všechny sloupce. Výstupem je transponovaný dataframe, tedy názvy sloupců ze zdrojového dataframe budou v jednom sloupci, ve druhém sloupci hodnoty z daného řádku. Nutné si uvědomit, že „2“ je název řádku, ne jeho index.
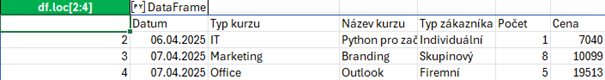
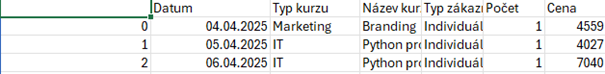
Df.loc[2:4] – výběr rozsahu řádků od index 2 až po index 4. Výstup je dataframe ve stejné podobě jako zdrojový dataframe.
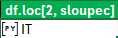
df.loc[2, ‚Typ kurzu‘] – Výběr jednoho řádku s indexem 2 a jednoho sloupce s názvem „typ kurzu“, který musí být ve stringu. Výstupem je jedna hodnota.
df.loc[2:3, [‚Typ kurzu‘, ‚Cena‘]] – Výběr vybraných řádků s indexem 2 až 4 a vybraných sloupců (typ kurzu a ceny) pomocí názvu sloupců. Více sloupců je nutné zadat do listu.
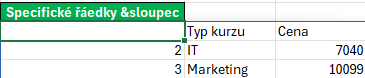
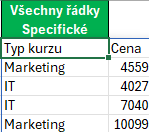
df.loc[:, [‚Typ kurzu‘, ‚Cena‘]] – Výběr všech řádků z dataframe a specifických sloupců (typ kurzu a cena). Pokud je potřebné vybrat všechny řádky, udává se pouze dvojtečka do prvního argumentu funkce.
iloc
Sekce “iloc”Definice
Sekce “Definice”Výběr řádků a sloupců podle pozice (position-based selection). Pokud je nutné vybrat sloupce a řádky názvem, existuje funkce loc.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Je možné zadat pouze vybrání řádku, více řádků, sloupce, více sloupců, nebo i sloupce a řádky či více řádků a sloupců najednou.
Pokud je nutné vybrat pouze jeden řádek a všechny sloupce, argument sloupců může být prázdný. Pokud je potřebné vybrat jeden sloupce, ale všechny řádky, je nutné zadat argument řádků.
Argumenty
Sekce “Argumenty”index (int, slice, nebo list) – Číselné pozice řádků/sloupců, které chcete vybrat.
df.iloc[row_index, column_index] (volitelný) – Kombinovaný výběr řádků a sloupců.
Použití
Sekce “Použití”df.iloc[2] – Výběr třetího řádku a všech sloupců.
df.iloc[2:4] – Rozsah vybraných řádků a všech sloupců.
df.iloc[:, 0] – Výběr všech řádků a prvního sloupce.
df.iloc[0, 1] – Výběr prvního řádku druhého sloupce.
df.iloc[2:3, 4:6] – Rozsah řádků a rozsah sloupců.
df.iloc[4, 0:2] – Jeden řádek a rozsah sloupců.
Filtrování
Sekce “Filtrování”Filtrovat data lze za pomocí reference dataframu a uvnitř něj nastavení dané podmínky na určitý sloupec nebo kombinaci sloupců.
Výběr jedné podmínky
Sekce “Výběr jedné podmínky”Praktické vysvětlení
Sekce “Praktické vysvětlení”df[df[‚column‘] > value] (bool mask) – Vrátí pouze řádky, které splňují podmínku daného sloupce. Pokud by byla použita pouze část df[‚column‘] > value, vrátí se stejný rozsah dataframe pouze s hodnotami TRUE/FALSE.
df.query(‚condition‘) – Filtrace pomocí dotazovacího jazyka, podobně jako v SQL.
Použití
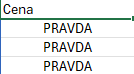
Sekce “Použití”df[‚Cena‘] > 4000 – vrátí buňky s obsahem PRAVDA, pokud podmínka platí. Pokud neplatí, vrátí NEPRAVDA. Výstupem bude pouze daný jeden sloupec.
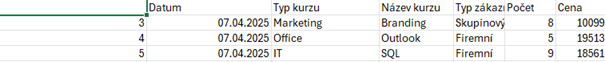
df[df[‚Cena‘] > 6000] – Vrátí celý dataframe se zdrojovými hodnotami, které splňují podmínku.

df[df[‚Typ kurzu‘] == „IT“] – Hodnota ve sloupci se musí rovnat přesné hodnotě.

df.query(‚Cena > 10000‘) – Filtr pomocí podmínky v textovém řetězci.
Výběr podle více podmínek
Sekce “Výběr podle více podmínek”df[(condition1) & (condition2)] – Pokud je potřebné použít více podmínek na stejný sloupec nebo více podmínek na ostatní sloupec a dané podmínky mají platit zároveň, používá se mezi podmínkami znak &.
df[(condition1) | (condition2)] – Pokud alespoň jedna z více podmínek musí platit, používá se znak |.
df[df[‚col‘].isin([val1, val2])] – Filtrace podle seznamu hodnot, podobné jako možnost platnosti alespoň jedné z podmínek.
Použití
Sekce “Použití”df[(df[‚Typ kurzu‘]==“IT“) & (df[‚Cena‘]<=10000)] – Podmínka, že daný kurz se musí rovnat „IT“ a zároveň ve sloupci cena musí být hodnota nižší než 10 000.

df[(df[‚Typ kurzu‘]==“IT“) | (df[‚Cena‘]<=10000)] – Alespoň jedna ze stanovených podmínek musí platit (buďto typ kurzu IT nebo cena menší než 10 000).
df[df[‚Typ kurzu‘].isin([„IT“, „Marketing“])] – V sloupci „Typ Kurzu“ má být vyfiltrována hodnota „IT“ nebo „marketing“.
Sample
Sekce “Sample”Definice
Sekce “Definice”Vrátí náhodný výběr řádků.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Výchozí nastavení vrátí 1 náhodný řádek z dataframu. Pokud je potřebné vrátit vyšší počet řádků, použije se argument n. Pokud je potřebné vrátit procento řádků ze všech dat, použije se frac.
Argumenty
Sekce “Argumenty”n – (int, volitelný): Počet řádků, které chcete náhodně vybrat.
frac (float, volitelný) – Frakce řádků (např. frac=0.1 vrátí 10 % všech řádků).
Replace (book, volitelný) – Výchozí nastavení na False, kdy není možné vybrat jeden řádek vícekrát. Pokud nastaveno na True, stejný řádek může být ve výběru víckrát.
Weights (str nebo ndarray-like, volitelný) – Výchozí hodnota „None“ má za následek stejnou váhu pravděpodobnosti. Pokud je argument prováděn na typu „Series“, zarovná se s cílovým objektem na indexu. Hodnoty indexu ve vahách nenalezených ve vzorkovaném objektu budou ignorovány a hodnotám indexu ve vzorkovaném objektu, který není ve vzorcích, budou přiřazeny váhy nula. Pokud je použito na typ „DataFrame“, přijme název sloupce, když osa = 0. Pokud váhy nejsou „series“, váhy musí mít stejnou délku jako vzorkovaná osa. Pokud se váhy nesčítají do 1, budou normalizovány na součet 1. Chybějící hodnoty ve sloupci vah budou považovány za nulu.
random_state (int, volitelný) – Nastavení seedu pro replikaci náhodného výběru.
Ignore_index (bool, volitelný) – Výchozí nastavení na False, kdy je indexem řádek z dataframe. Pokud nastaveno na True, index řádků nebude zobrazen.
Použití
Sekce “Použití”df.sample() – Vrátí jeden náhodný řádek z dataframe.
df.sample(n=5) – Vrátí 5 náhodných řádků z dataframe.
df.sample(frac=0.1) – Vrátí 10 % řádků z dataframe náhodně.
df.sample(n=10, ignore_index=True) – 10 náhodných řádků, index nebude zobrazen.
df.sample(n=10, weights=’Cena‘) – 10 náhodných řádků, kde váhou je sloupec „Cena“ z dataframe. Pokud je použit sloupec jako váha, je pravděpodobnější, že řádky, kde jsou hodnoty ve sloupci „Cena“ vysoké, budou s větší pravděpodobností vybrány než hodnoty, které jsou ve sloupci „Cena“ nízké.
Nunique
Sekce “Nunique”Definice
Sekce “Definice”Vrátí počet unikátních hodnot v každém sloupci.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Výchozí nastavení je vrácení unikátních hodnot v každém sloupci, je možné nastavit i pro řádky, pokud je dataframe otočený. Funkce je schopna ignorovat prázdné buňky.
Argumenty
Sekce “Argumenty”Axis (int, volitelný) – Určuje, zda počítat unikátní hodnoty pro sloupce (axis=0), což je výchozí možnost, nebo pro řádky.
Dropna (bool, volitelný) – Zda ignorovat prázdné buňky při počítání. Výchozí nastavení ignoruje prázdné hodnoty.
Použití
Sekce “Použití”df.nunique() – Vrátí unikátní hodnoty v každém sloupci dataframu.
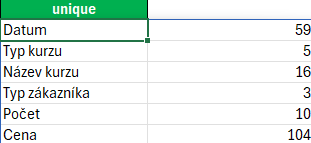
df.nunique(axis=1) – Vrátí unikátní hodnoty v každém řádku.
df.nunique(dropna=False) – Pokud jsou v datech prázdné hodnoty, bude se počítat tato hodnota jako unikátní, jelikož je nastavena na „False“.
Sort_values
Sekce “Sort_values”Definice
Sekce “Definice”Seřadí DataFrame podle hodnot v konkrétním sloupci.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Dataframe lze seřadit i na základě více než jednoho sloupce stejně jako v klasické Excelu při víceúrovňovém řazení. Lze řadit od nejnižší po nejvyšší či obráceně, popř. od A do Z nebo obráceně.
Argumenty
Sekce “Argumenty”by (str nebo list of str, volitelný) – Název sloupce/sloupců, podle kterých se má řadit.
Axis (0 nebo 1, volitelný) – řazení dle sloupce nebo řádků. Výchozí nastavení dle sloupců (axis = 0).
ascending (bool nebo list of bool, volitelný, default=True) – Zda řadit vzestupně (True) nebo sestupně (False).
Inplace (bool, volitelný) – zdali řadit na místě „in place“ nebo mimo. Výchozí nastavení na false.
Kind ({‘quicksort’, ‘mergesort’, ‘heapsort’, ‘stable’}, default ‘quicksort’ ) – Způsob řadícího algoritmu, o kterém je možné se více dočíst na knihovně numpy funkci sort(). „mergesort“ a „stable“ jsou jediné stabilní algoritmy. Pro DataFrames se tato možnost použije pouze při řazení podle jednoho sloupce nebo labelu. Není nutné ho nijak vyplňovat, pokud jde o klasické řazení dat.
na_position ({‘first’, ‘last’}, volitelný, default=‘last’) – Určuje, kam umístit prázdné hodnoty buňky, zdali na konec v řazení nebo na začátek.
Ignore_index (bool, volitelný) – Výchozí nastavení na False, kdy je indexem řádek z dataframe. Pokud nastaveno na True, index řádků nebude zobrazen.
Použití
Sekce “Použití”df.sort_values(by=“Cena“) – Řazení dle číselného sloupce vzestupně.
df.sort_values(by=“Název kurzu“) – Řazení dle textového sloupce vzestupně.
df.sort_values(by=“Cena“, ascending=False) – Řazení sloupce sestupně.
df.sort_values(by=“Cena“, ascending=False, na_position=’first‘) – Řazení sloupce sestupně, přičemž prázdné hodnoty budou v řazení první.
df.sort_values(by=[„Název kurzu“, „Cena“]) – Nejprve řazení dle sloupce „Název kurzu“, dle stejné kategorie kurzu následné řazení dle sloupce „Cena“. Oba sloupce řazeny vzestupně, jelikož není specifikováno v argumentu.
df.sort_values(by=[„Název kurzu“, „Cena“], ascending=[True, False]) – Nejprve řazení dle sloupce „Název kurzu“ poté dle sloupce „Cena“. První sloupec je řazen vzestupně, sloupec „Cena“ je řazena sestupně.
© 2026 Excelland