Čištění dat
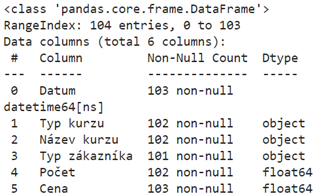
Uvažujme proměnnou s názvem df, ve které budou uloženy data z Excelu se sloupci datum, typ kurzu, název kurzu, typ zákazníka, počet a cena, na kterých se bude provádět výběr dat. Základní charakteristika dat je následující:
df = xl(„A1:F105“, headers=True)
df.info()
DropNA
Sekce “DropNA”Definice
Sekce “Definice”Funkce odstraní řádky nebo sloupce obsahující chybějící hodnoty (NaN).
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce dokáže odstraňovat celé řádky nebo sloupce z dataframe dle nastavení v jednotlivých argumentech. Je možné nastavit specifické sloupce resp. řádky na kontrolu, nemusí se kontrolovat celý dataframe.
Argumenty
Sekce “Argumenty”axis (int nebo {0 nebo ‚index‘, 1 nebo ‚columns‘}, výchozí=0) – Určuje, zda odstranit řádky (axis=0) nebo sloupce (axis=1).
how ({‚any‘, ‚all‘}, výchozí=’any‘):
- ‚any‘ – Odstraní řádky (resp. sloupce při nastavení axis=1), pokud je v řádku alespoň jedna hodnota prázdná (NaN).
- ‚all‘ – Odstraní řádky (resp. sloupce při nastavení axis=1), pokud jsou všechny hodnoty v řádku prázdné (NaN).
thresh (int, volitelné) – Minimální počet neprázdných hodnot, které musí být přítomny, aby řádek/sloupec nebyl odstraněn. Nemůže být kombinováno s argumentem „how“.
subset (array, volitelné) – Specifikuje konkrétní sloupce/řádky pro kontrolu prázdných buněk.
inplace (bool, výchozí=False) – Pokud je True, úpravy se aplikují přímo na původní DataFrame. Pokud False, úpravy se upraví na nový dataframe v Pyhtonu.
Ignore_index (bool, výchozí=False, volitelný) – Výchozí nastavení na False, kdy je indexem řádek z dataframe. Pokud nastaveno na True, index řádků nebude zobrazen.
Použití
Sekce “Použití”df.dropna() – Smaže řádky v případě, kdy je alespoň 1 buňka v řádku prázdná.
df.dropna(how=’all‘) – Smaže řádky pouze v případě, kdy je celý řádek buněk prázdný.
df.dropna(thresh=4) – Pokud jsou alespoň 4 buňky v řádku vyplněny, nebude tento řádek smazán.
df.dropna(subset=“Typ kurzu“) – Řádky budou smazány pouze pokud jsou prázdné v sloupci „Typ kurzu“.
df.dropna(subset=[„Typ kurzu“, „Počet“]) – Řádky budou smazány pouze pokud jsou prázdné v buňkách sloupce „Typ kurzu“ NEBO sloupce „Počet“.
df.dropna(ignore_index=True) – Index řádku nebude ve výstupu vypsán.
FillNA
Sekce “FillNA”Definice
Sekce “Definice”Nahradí chybějící hodnoty (NaN) specifikovanou hodnotou.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce zvládne pro všechny prázdné buňky vyplnit jednu hodnotu, popř. je možné specifikovat pro každý sloupec jinou hodnotu, která má být namísto prázdných buněk vyplněna. Je možné využít funkci i pro vyplnění hodnot z předešlých nebo dalších hodnot.
Argumenty
Sekce “Argumenty”value (scalar, dict, Series, nebo DataFrame): Hodnota, kterou chcete nahradit prázdné buňky. Může být jedním číslem, textem nebo slovníkem pro různé hodnoty podle sloupců.
method ({‚backfill‘, ‚bfill‘, ‚pad’, ‚ffill‘}, volitelný):
- ‚ffill‘ (forward fill): Vyplní pomocí předchozí hodnoty ve stejném sloupci.
- ‚bfill‘ (backward fill): Vyplní pomocí následující hodnoty ve stejném sloupci.
axis (int nebo {0 nebo ‚index‘, 1 nebo ‚columns‘}, výchozí=0) – Určuje, zda použít metodu podle řádků nebo sloupců.
inplace (bool, výchozí=False) – Pokud je True, úpravy se aplikují přímo na původní DataFrame.
limit (int, volitelný) – Maximální počet hodnot, které mohou být vyplněny po sobě (např. ze specifikovaného dataframe, slovníku…).
Použití
Sekce “Použití”df.fillna(0) – Všechny prázdné buňky budou nahrazeny hodnotou 0.
df.fillna(„Nevyplněno“) – Všechny prázdné buňky budou nahrazeny slovem „Nevyplněno“.
df.fillna(value={‚Název kurzu‘: ‚Nevyplněno‘, ‚Počet‘: 0})}) – Nahradí prázdné buňky v sloupci „název kurzu“ slovem „nevyplněno“ a v sloupci „Počet“ číslem 0. Ostatní sloupce, pokud mají nevyplněné buňky, budou stále prázdné, jelikož nejsou specifikované v argumentu.
df.fillna(method=’bfill‘) – Vyplnění prázdných buněk předchozí hodnotou ve stejném sloupci.
df.fillna(method=’bfill‘, axis=1) – Vyplnění prázdných buněk předchozí hodnotou ve stejném řádku.
Replace
Sekce “Replace”Definice
Sekce “Definice”Nahradí konkrétní hodnoty v DataFrame jinými hodnotami.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Hodnoty můžou být nahrazeny jednou konkrétní hodnotou nebo i listem nebo slovníkem hodnot. Pokud hodnoty mají být nahrazeny listem hodnot, pak musí být stejné délky.
Argumenty
Sekce “Argumenty”to_replace (scalar, list, dict, nebo regex) – Hodnota, která má být nahrazena.
value (scalar, list, nebo dict) – Nová hodnota, kterou má být předchozí nahrazena.
inplace (bool, výchozí=False) – Pokud je True, úpravy se aplikují přímo na původní DataFrame.
regex (bool, výchozí=False) – Pokud je True, použije argument to_replace jako regulární výraz.
Limit (int, výchozí=None) – Maximální velikost mezery do popředí nebo pozadí vyplnění.
Method ({‚pad‘, ‚ffill‘, bfill‘}) – Jaká metoda má být použita při nahrazení. Pokud je argument „to_replace“ skalár, list nebo tuple a argument value je „none“.
Použití
Sekce “Použití”df.replace(to_replace=5, value=0) – Nahrazení hodnoty 5 hodnotou 0 v celém dataframu.
df.replace(to_replace=[„Python pro pokročilé“, „Python pro začátečníky“], value=“Python“) – Nahrazení obou textů „Python pro pokročilé“ a „Python pro začátečníky“ pouze hodnotou „Python“.
df.replace(to_replace=[1,2,5], value=[0,1,3]) – Nahrazení čísla 1 za 0, také čísla 2 za 1 a také čísla 5 za 3.
df.replace(to_replace=r‘.*ekonomie‘, value=’Finance‘, regex=True) – Nahrazení textu „ekonomie“ a také čehokoliv, co je před textem „ekonomie“ díky regulárnímu výrazu „.*“ (jedná se např. o slova jako mikroekonomie nebo makroekonomie, obě budou nahrazeny) za slovo „Finance“.
Drop
Sekce “Drop”Definice
Sekce “Definice”Odstraní specifikované řádky nebo sloupce.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce odstraní řádky nebo sloupce zadáním názvů labelů a odpovídajících os nebo přímým zadáním názvů indexů nebo sloupců. Při použití více indexů lze popisky na různých úrovních odstranit zadáním úrovně.
Argumenty
Sekce “Argumenty”labels (single label nebo list) – Název nebo názvy řádků/sloupců, které mají být odstraněny.
axis (int nebo {0 nebo ‚index‘, 1 nebo ‚columns‘}, výchozí=0) – Určuje, zda odstranit řádky (axis=0) nebo sloupce (axis=1).
inplace (bool, výchozí=False) – Pokud je True, úpravy se aplikují přímo na původní DataFrame.
Level (int, volitelný) – Pro víceúrovňovou indexovou úroveň, ze které budou řádky/sloupce odstraněny.
Errors ({‘ignore’, ‘raise’}, výchozí=‘raise’) – pokud nastaveno na „ignore“, potlačí chybu a pouze existující řádky/sloupce jsou odstraněny.
Použití
Sekce “Použití”df.drop(labels=0) – Odstranění prvního řádku.
df.drop(labels=’Cena‘, axis=1) – Odstranění sloupce „Cena“.
df.drop(labels=[‚Cena‘, ‚Počet‘], axis=1) – Odstranění sloupce „Cena“ a „Počet“.
Duplicated
Sekce “Duplicated”Definice
Sekce “Definice”Vrátí binární masku označující, zda se všechny řádky opakují.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Výstupem bude series ze zdrojového dataframe. Hodnota True se objeví v případě, kdy všechny hodnoty v řádku se opakují v jiném řádku. Pokud je potřebné zjistit opakující se hodnoty pouze na určitých sloupcích, je nutné zadat argument „subset“. Je možné označovat duplicity od začátku nebo od konce dataframu. Pokud je potřebné duplicity odstranit, je nutné použít funkci drop_duplicates.
Argumenty
Sekce “Argumenty”subset (list, volitelný) – Specifikuje sloupce, na které se má zaměřit při kontrole duplicity.
keep ({‚first‘, ‚last‘, False}, výchozí=’first‘):
- ‚first‘: Označí všechny duplicity kromě prvního jako True.
- ‚last‘: Označí všechny duplicity kromě posledního jako True.
- False: Označí všechny duplicity jako True, tedy i první resp. poslední.
Použití
Sekce “Použití”df.duplicated() – Výstupem bude „True“ pouze v případě, kdy celý řádek je stejný jako jiný řádek v dataframe. První duplicitní řádek zůstane jako „False“.
df.duplicated(‚Typ kurzu‘) – Specifikace jednoho sloupce, kde se duplicity mají hledat, tedy ne na celém dataframe. První duplicitní hodnota zůstane jako „False“, ostatní duplicitní hodnoty budou „True“.
df.duplicated([‚Typ kurzu‘, ‚Název kurzu‘]) – Pokud bude v sloupci „Typ kurzu“ a zároveň sloupci „Název kurzu“ stejná hodnota v jiném řádku, bude výstupem „True“, jinak „False“. První řádek s duplicitními hodnotami zůstane „False“.
df.duplicated(subset=’Typ kurzu‘, keep=’last‘) – Specifikace jednoho sloupce, kde se duplicity mají hledat, tedy ne na celém dataframe. Poslední duplicitní hodnota zůstane jako „False“, ostatní duplicitní hodnoty budou „True“.
df.duplicated(subset=’Typ kurzu‘, keep=False) – Jako „True“ budou označeny všechny duplicitní hodnoty, tedy i ta v prvním, resp. posledním řádku dataframu.
Drop_duplicates
Sekce “Drop_duplicates”Definice
Sekce “Definice”Odstraní duplikované řádky.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Výstupem bude dataframe bez duplicitních hodnot se stejnými hodnotami jako v zdrojovém dataframe. Duplicitní řádek se odstraní pouze v případě, kdy jsou všechny hodnoty v řádcích stejné jako v předchozích řádcích. Podobná logika jako u funkce drop s rozdílem, že řádky přímo maže a neukazuje binární výstup TRUE/FALSE. Pokud je potřebné zjistit opakující se hodnoty pouze na určitých sloupcích, je nutné zadat argument „subset“. Je možné označovat duplicity od začátku nebo od konce dataframu argumentem „keep“.
Argumenty
Sekce “Argumenty”subset (list, volitelný): Specifikuje sloupce, na které se má zaměřit při odstraňování duplicit.
keep ({‚first‘, ‚last‘, False}, default=’first‘):
- ‚first‘: Ponechá první výskyt duplicity.
- ‚last‘: Ponechá poslední výskyt duplicity.
- False: Odstraní všechny výskyty duplicit.
inplace (bool, default=False): Pokud je True, úpravy se aplikují přímo na původní DataFrame.
Ignore_index (bool, výchozí=False, volitelný) – Pokud nastaveno na True, index řádků nebude zobrazen.
Použití
Sekce “Použití”df.drop_duplicates() – Odstraní se pouze řádky, které mají ve všech buňkách řádku stejné hodnoty jako v předešlém řádku. První řádek s duplicitami zůstane, jelikož se po odstranění bude jednat o unikátní řádek.
df.drop_duplicates(‚Typ kurzu‘) – Specifikace jednoho sloupce, na základě kterého se mají duplicity odstraňovat, odstraní se však celý řádek dle hodnoty ze specifikovaného sloupce.
df.drop_duplicates([‚Typ kurzu‘, ‚Název kurzu‘]) – Pokud bude v sloupci „Typ kurzu“ a zároveň sloupci „Název kurzu“ stejná hodnota v jiném řádku, duplicitní řádky kromě prvního budou odstraněny.
df.drop_duplicates(subset=’Typ kurzu‘, keep=’last‘) – Specifikace jednoho sloupce, kde se duplicity mají odstranit (ne na celém dataframe). Poslední duplicitní hodnota zůstane v datech.
df.drop_duplicates(subset=’Typ kurzu‘, keep=False) – Budou odstraněny všechny duplicitní řádky, tedy i první resp. poslední.
df.drop_duplicates(‚Typ kurzu‘, ignore_index=True) – Sloupec s indexem nebude zobrazen.
Rename
Sekce “Rename”Definice
Sekce “Definice”Přejmenuje sloupce nebo řádky.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Přejmenování sloupce/řádku se provádí pomocí slovníku. Kdy klíčem slovníku je aktuální název sloupce/řádku a hodnotou je nový název sloupce/řádku. Pokud se jedná o přejmenování sloupců, je vhodnější používat argument „columns“ než „mapper“, jelikož v případě argumentu „mapper“ je nutné specifikovat i argument „axis“. Pokud sloupec není nalezen, nevyskočí error, lze ale zapnout hlášení erroru v argumentu „errors“.
Argumenty
Sekce “Argumenty”mapper (dict nebo function) – Slovník nebo funkce určující přejmenování.
Index (dict nebo funkce) – Alternativa, pokud nechcete používat argument mapper a axis. Tímto argumentem je rovnou specifikováno, že se jedná o řádky.
Columns (dict nebo funkce) – Alternativa, pokud nechcete používat argument mapper a axis. Tímto argumentem je rovnou specifikováno, že se jedná o sloupce.
axis (int nebo {0 nebo ‚index‘, 1 nebo ‚columns‘}, default=’index‘) – Určuje, zda měnit názvy řádků (axis=0) nebo sloupců (axis=1).
copy (bool, výchozí=True) – Zkopíruje zdrojové data.
inplace (bool, výchozí=False): Pokud je True, úpravy se aplikují přímo na původní DataFrame.
Errors ({‘ignore’, ‘raise’} výchozí=‘ignore’) – Ignoruje chyby v případě, kdy sloupec/řádek není nalezen. Pokud nastaveno na „raise“, error se ukáže v případě neexistujícího názvu řádku/sloupce.
Použití
Sekce “Použití”df.rename(mapper={‚Typ zákazníka‘: ‚Zákazník‘}, axis=1) – Přejmenování sloupce „Typ zákazníka“ za nový název „Zákazník“ pomocí specifikování argumentu mapper a axis.
df.rename(columns={‚Typ zákazníka‘: ‚Zákazník‘}) – Přejmenování sloupce „Typ zákazníka“ za nový název „Zákazník“. Není nutné specifikovat axis a mapper, jelikož je použit argument columns.
df.rename(columns={‚Typ zákazníka‘: ‚Zákazník‘, ‚Název kurzu‘: ‚Kurz‘}) – Přejmenování 2 sloupců.
df.rename(columns={‚Neexistujici‘: ‚Zákazník‘}, errors=’raise‘) – Pokud sloupec neexistuje, v pythonu bude error. Pokud by bylo zanecháno výchozí nastavení na ignorování erroru, dataframe by se zobrazil bez přejmenovaného neexistujícího sloupce.
Interpolate
Sekce “Interpolate”Definice
Sekce “Definice”Nahradí chybějící hodnoty (NaN) interpolací, tj. odhadem hodnot na základě okolních dat.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce funguje zejména pro okolní číselné hodnoty. Pokud okolní hodnoty jsou textové a pravděpodobně by měl být vyplněn také textový údaj, je vhodné využít metodu „pad“ v argumentu „method“ a zároveň argument „limit_direction“. Pro vyplnění textových hodnot je lepší použit funkci fillNA.
Argumenty
Sekce “Argumenty”method (str, výchozí=’linear‘) – Typ interpolace. Možnosti:
- ‚linear‘ – Lineární interpolace mezi hodnotami.
- ‚polynomial‘ – Polynomická interpolace (je nutné zadat stupeň pomocí order).
- ‚time‘ – Interpolace založená na časových datech (používá index).
- ‘index’, ‘values’ – Používají skutečné číselné hodnoty indexu.
- ‘pad’: – Vyplní prázdné hodnoty existujícími daty.
- ‘nearest’, ‘zero’, ‘slinear’, ‘quadratic’, ‘cubic’, ‘barycentric’….
axis (int, výchozí=0) – Určuje, zda interpolovat podle řádků (axis=0) nebo sloupců (axis=1).
limit (int, volitelný) – Maximální počet hodnot, které mohou být interpolovány za sebou.
inplace (bool, výchozí=False): Pokud je True, úpravy se aplikují přímo na původní DataFrame.
limit_direction ({‚forward‘, ‚backward‘, ‚both‘}, volitelný):
- ‚forward‘ – Interpolace směrem dopředu.
- ‚backward‘ – Směrem zpět.
- ‚both‘ – Oběma směry.
Záleží, zdali je argument specifikován nebo nikoliv, dle toho se nastavují jednotlivé možnosti směru:
Pokud je limit specifikován:
- Pokud argument „method“ je „pad“ nebo „ffill“, tak tento argument musí být „forward“.
- Pokud argument „method“ je „backfill“ nebo „bfill“, tento argument musí být „backward“.
Pokud není limit specifikován:
- Pokud argument „method“ je „backfill“ nebo „bfill“, výchozí metodou je „backward“.
- Za jiných podmínek výchozí metodou je „forward“.
limit_area ({None, ‘inside’, ‘outside’}, výchozí=None) – Pokud je argument „limit“ specifikován, jednotlivé prázdné buňky budou vyplnění daným omezením.
- None – Žádné omezení vyplnění.
- Inside – Vyplní pouze prázdné hodnoty obklopený vyplněnými hodnotami
- Outside – Vyplní pouze prázdné hodnoty mimo validní hodnoty.
Použití
Sekce “Použití”df.interpolate() – Lineární interpolace bez omezení, kdy vyplněny budou zejména buňky, které jsou obklopeny číselnými hodnotami. Buňky obklopené textovými hodnotami budou „None“.
df.interpolate(method=’pad’, axis=0, limit_direction=’forward‘) – Hodnoty budou vyplněný z předešlých řádků stejného sloupce.
df.interpolate(method=’linear‘, limit=2, axis=0) – Lineární interpolace s omezením na max 2 po sobě jdoucí prázdné buňky.
Add_prefix
Sekce “Add_prefix”Definice
Sekce “Definice”Přidá předponu ke všem názvům sloupců nebo řádkům.
Argumenty
Sekce “Argumenty”prefix (str) – Řetězec, který bude přidán na začátek názvu každého sloupce.
Axis ({0 nebo ‘index’, 1 nebo ‘columns’, None}, výchozí=None) – Osa, na kterou má být předpona přidána (sloupce/řádky).
Použití
Sekce “Použití”df.add_prefix(‚data_‘) – Přejmenuje sloupce na ‚data_col1‘, ‚data_col2‘, …
Add_suffix
Sekce “Add_suffix”Definice
Sekce “Definice”Přidá příponu ke všem názvům sloupců.
Argumenty
Sekce “Argumenty”suffix (str) – Řetězec, který bude přidán na konec názvu každého sloupce.
Axis ({0 nebo ‘index’, 1 nebo ‘columns’, None}, výchozí=None) – Osa, na kterou má být přípona přidána (sloupce/řádky).
Použití
Sekce “Použití”df.add_suffix(‚_data‘) – Přejmenuje sloupce na ‚col1_data‘, ‚col2_data‘, …
Reset_index
Sekce “Reset_index”Definice
Sekce “Definice”Resetuje index DataFrame na výchozí číslování (0, 1, 2, …). Původní index lze uložit jako nový sloupec.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Ve většině již použitých metodách na výběr nebo odstranění dat se dataframe přidá index od 0 po n-řádků. Pokud nebylo argumentem ignore_index specifikováno False v dané funkci, je možné využít tuto funkci „reset_index“ pro resetování indexu.
Argumenty
Sekce “Argumenty”drop (bool, výchozí=False) – Pokud True, původní index nebude uložen jako nový sloupec.
inplace (bool, výchozí=False) – Pokud True, změna se aplikuje přímo na původní DataFrame.
level (int, str, nebo list, volitelný) – Resetuje pouze specifikované úrovně indexu (pro multi-index).
Použití
Sekce “Použití”df.reset_index(drop=True) – Resetuje index a nepřidává původní index jako nový sloupec
Set_index
Sekce “Set_index”Definice
Sekce “Definice”Nastaví konkrétní sloupec z dataframe jako index.
Argumenty
Sekce “Argumenty”keys (label neb array): Název sloupce/sloupců, které chcete použít jako index.
drop (bool, výchozí=True): Pokud True, původní sloupce použité jako index budou odstraněny.
inplace (bool, výchozí=False): Pokud True, změna se aplikuje přímo na DataFrame.
Použití
Sekce “Použití”df.set_index(‚Datum‘) – Nastaví sloupec „Datum“ jako index.
Sort_index
Sekce “Sort_index”Definice
Sekce “Definice”Seřadí DataFrame podle hodnot indexu.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Je nutné nejprve nastavit sloupec, který má být indexem. Index může být i výchozí, v takovém případě ale data již seřazená budou, pokud není před nimi např. použita funkce sort_values pro jiný sloupec.
Argumenty
Sekce “Argumenty”axis (int, výchozí=0): Určuje, zda řadit podle řádků (axis=0) nebo sloupců (axis=1).
level (int nebo level name, volitelný): Specifikuje úroveň indexu (pro multi-index), podle které se má řadit.
ascending (bool nebo list of bool, výchozí=True): Určuje směr řazení.
inplace (bool, výchozí=False): Pokud True, změna se aplikuje přímo na DataFrame.
Použití
Sekce “Použití”Df.set_index(„Datum“) – Nejprve nastavený sloupec „Datum“ jako index funkcí set_index.
Df.sort_index() – Seřadí dataframe vzestupně dle indexu.
Df.sort_index(ascending=False) – Seřadí DataFrame sestupně podle indexu
Astype
Sekce “Astype”Definice
Sekce “Definice”Změní datový typ sloupce na specifikovaný datový typ.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Datový typ se změní uvnitř dataframu v Pythonu, ale hodnoty v buňkách můžou vypadat stále nezměněné. Např. pokud v klasickém Excelu jsou buňky nastavené jako datový typ „číslo“, ale sloupec v dataframe v pythonu změníte na „Date“, výstup v buňkách bude stále vypadat jako číslo, ale Python s buňkami bude pracovat jako „Date“.
Argumenty
Sekce “Argumenty”dtype (data type, dict of {column: dtype}, nebo scalar): Nový datový typ pro jednotlivé sloupce nebo všechny sloupce.
errors ({‘raise’, ‘ignore’}, výchozí=‘raise’) – Pokud typ nelze převést, v pythonu bude error. Lze potlačit změnou argumentu na metodu „ignore“ např. pokud jsou některé buňky z oblasti prázdné.
Použití
Sekce “Použití”Df.astype({‚Typ kurzu‘: ‚str‘}) – Změní datový typ sloupce „typ kurzu“ na textový řetězec.
df.astype({‚Počet‘: ‚int32‘, ‚Cena‘: ‚float64‘}) – změní datový typ sloupce Počet na číslo (integer) a datový typ sloupce „Cena“ na desetinné číslo.
df.astype({‚Počet‘: ‚int32‘, ‚Cena‘: ‚float64′}, errors=’ignore‘) – Ignorování chyby v případě, že nelze všechny buňky převést (např. z důvodu chybějících dat).
pd.to_datetime(df[‚Datum‘]) – změní datový typ sloupce „Datum“ na „Date“. Výstupem bude pouze sloupec Datumu.
pd.to_datetime(df[‚Datum‘], format=’%Y-%m-%d‘) – Převede sloupec „Datum“ na datetime ve formátu rok, měsíc a rok s pomlčkami mezi nimi. Změna bude vidět pouze v editoru pythonu, nikoliv v daných buňkách.
© 2026 Excelland