RegexExtrahovat
enREGEXEXTRACT
Definice
Sekce “Definice”Funkce umožňuje extrahovat část textového řetězce na základě regulárního výrazu (RegEx).
Vzorec
Sekce “Vzorec”=REGEXEXTRAHOVAT(Text;Pattern;[return_mode];[case_sensitivity])Argumenty funkce
Sekce “Argumenty funkce”Text (povinné) – Textový řetězec, ze kterého má být extrahovaná část na základě vzoru.
Pattern (povinné) – Regulární výraz určující vzor, podle kterého bude text extrahován.
Return_mode (volitelné, výchozí=0) – Číslo určující jaké řetězce mají být extrahovány:
- 0 – Vrátí první řetězec, který odpovídá vzoru.
- 1 – Vrátí všechny řetězce odpovídající vzoru jako pole.
- 2 – Vrátí zachycené skupiny první shody jako pole, přičemž skupina je obklopená závorkou ().
Case_sensitivity (volitelné, výchozí=0) – Určuje, zdali mají být rozlišovány velká a malá písmena.
- 0 – Rozlišovat malá a velká písmena.
- 1 – Nerozlišovat malá a velká písmena.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Regulární výraz (RegEx) je speciální řetězec znaků, který slouží k vyhledávání, extrahování a manipulaci s textem na základě určitých vzorců a umožňuje složité operace s vyhledáváním určitých vzorů textových řetězců. Testovat regulární výrazy lze např. na stránce regex101.com.
Při psaní vzorů lze také použít tzv. tokeny, které odpovídají různým znakům:
- [0-9] – Libovolná číselná pozice
- [a-z] – Znak v rozsahu a až z
- . – Libovolný znak
- .* – Všechny znaky
- \d – Libovolné číslo
- \d* – Všechny čísla za sebou
- a – Znak „A“
- a* – žádné nebo více „a“
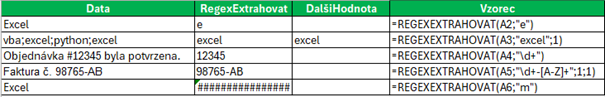
V příkladu je použito více regulárních výrazů. V druhém řádku má být nalezeno písmeno „e“ a vráceno do dané buňky se vzorcem, přičemž výchozí nastavení je, že záleží na velikosti písmen, proto bude vráceno malé „e“. V dalším příkladu má být nalezeno slovo „Excel“ v textovém řetězci, přičemž pokud se nachází toto slovo víckrát, mají být vráceny všechny výskyty do dalších buněk v jednom řádku, tedy výstup nemusí být pouze jedno buňkový, ale jedná se o maticový výstup. V další příkladu 3 mají být navráceny všechny čísla, které jsou nalezeny v textovém řetězci. V příkladu 4 budou vráceny všechny čísla, následně pomlčka a jakékoliv velká písmena za pomlčkou. Pokud se hledaný regulární výraz v textovém řetězci nenachází, bude vrácena chyba ve formátu #N/A.
Použití s ostatními funkcemi
Sekce “Použití s ostatními funkcemi”Pokud má být zjištěno, kolikrát se daný vzorek nachází v textovém řetězci, je možné využít kombinace s funkcí Počet2. Pokud bude např. slovo 2x výstupem z textového řetězce, bude výsledek 2.
=POČET2(REGEXEXTRAHOVAT(A2; „excel“;1))Pokud má být regulární výraz v textu nalezen a následně nahrazena určitá část, je možné funkci kombinovat s funkcí RegexNahradit. Např. pokud by byly buňky s textem jako „Datum faktury: 15/02/2025 bylo schváleno.“ a bylo by nutné extrahovat pouze dané datum, přičemž lomítka by měly být nahrazeny za tečky, je možné použít následující výraz.
=REGEXNAHRADIT(REGEXEXTRAHOVAT(J2;“\d{2}/\d{2}/\d{4}“); „/“; „.“)Pokud má být určitý text spojen s určitým dalším extrahovaným textem, přičemž mezi jednotlivé výstupy má být vložen oddělovač, je možné využít funkce TextJoin. Např. pokud v sloupci „A“ bude vždy čtyřmístné číslo a další písmena jako „6478KK“ a v buňce „B“ budou vždy 4 čísla a další písmena jako „8554CZASDF“, přičemž mají být pouze extrahovány čísla a vloženy do jedné buňky s oddělovačem středníku, je možné využít následující vzorec.
=TEXTJOIN(„;“;1;REGEXEXTRAHOVAT(A2:B2;“\d{4}“))Pokud má být nejprve zjištěno, zdali se skutečně regulární výraz v ve zvoleném textu nachází, je možné funkci kombinovat s funkcemi Když a RegexTest. Pokud mají být např. hledány čísla, které jako jediné mají být extrahovány, nejprve se provede test, pokud zde čísla jsou, bude vráceno pouze dané číslo. Pokud se čísla v textu nenachází, bude vrácena původní hodnota.
=KDYŽ(REGEXTEST(A2;“\d+“);REGEXEXTRAHOVAT(A2;“\d+“);A2)Související funkce
Sekce “Související funkce”
© 2026 Excelland