TextPřed
enTEXTBEFORE
Definice
Sekce “Definice”Funkce extrahuje část textu, která se nachází před specifikovaným oddělovačem.
Vzorec
Sekce “Vzorec”=TEXTPŘED(Text; Oddělovač; [Instance_num]; [Match_mode]; [Match_end];[If_not_found])Argumenty funkce
Sekce “Argumenty funkce”Text (povinný) – Textový řetězec, ze kterého má být text extrahován.
Oddělovač (povinný) – Text nebo znak, který označuje bod, kde se text rozdělí.
Instance_num (volitelný) – Udává, který výskyt oddělovače se má použít (výchozí hodnota = 1). Pokud je např. v textovém řetězci stejných oddělovačů více, je možné nastavit, od kterého výskytu má být text extrahován, zdali od druhého, třetího atd. Pokud má být např. text extrahován zprava a tedy poslední výskyt oddělovače má být nalezen, je možné zadat do argumentu -1. Stejně tak s dalšími negativními čísly. Pokud by měl být nalezen předposlední oddělovač, do argumentu by bylo zadáno -2.
Match_mode (volitelný, výchozí=0) – Režim porovnání velkých a malých písmen:
- 0 – rozlišuje velká/malá písmena,
- 1 – nerozlišuje velká/malá písmena.
Match_end (volitelný) – Zachází s koncem textu jako s oddělovačem. Ve výchozím nastavení se text přesně shoduje.
- 0 – Nepřizpůsobuje oddělovač konci textu
- 1 – Přiřadí oddělovač ke konci textu
If_not_found (volitelný) – Jaká hodnota má být navrácena, pokud se oddělovač nenalezne. Výchozím nastavením je, že v případě nenalezení oddělovače bude vrácena chyba #N/A. Je možné nastavit vlastní text nebo vložené funkce.
Praktické vysvětlení
Sekce “Praktické vysvětlení”Funkce je prakticky vylepšenou verzí kombinací funkcí Zleva a Najít, popř. i funkce Zprava. Oproti zmíněné kombinace funkcí Zleva a Najít si sama dokáže nalézt danou pozici, na které se oddělovač nachází i kolikrát v textovém řetězci existuje. Zároveň je možné specifikovat, kolikátým oddělovačem má být text rozdělen. Navíc je možné hledat oddělovač i od konce textového řetězce. Pokud navíc oddělovač v textovém řetězci není přítomen, je možné využít argumentu If_not_found a nastavit vlastní výstupní hodnotu v případě nenalezení.
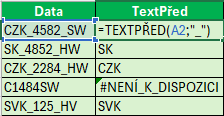
Zde je příklad nalezení textu před oddělovačem prvního podtržítka, přičemž pokud se podtržítko nenalezne, výstup je chyba #NENÍ_K_DISPOZICI:
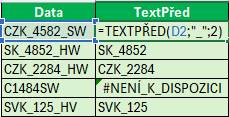
Extrakce textu před nalezením druhého oddělovače podtržítka:
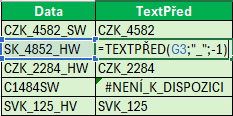
Nalezení textu před posledním nalezeným podtržítka:
Pokud podtržítko není nalezeno, je navíc vrácen text „Oddělovač nenalezen“:
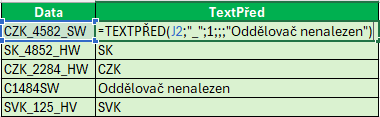
Použití s ostatními funkcemi
Sekce “Použití s ostatními funkcemi”Pokud jsou data ve dvou sloupcích, přičemž mají být spojené data ze dvou sloupců a vždy před daným oddělovačem, je možné použít funkci s kombinací funkce Concat.
=CONCAT(TEXTPŘED(A2;“_“);“|“; TEXTPŘED(B2;“_“))Stejně tak lze kombinovat funkce s funkcí TextZa, pokud je nutné spojit např. data ze sloupce „A“ před oddělovačem a data ze sloupce „B“ za oddělovačem pomocí funkce Concat.
=CONCAT(TEXTPŘED(A2;“_“);“|“; TEXTZA(B2;“_“))Pokud má být např. zjištěn text před druhým oddělovačem, ale není jisté, že má text 2 stejné oddělovače, přičemž pokud se nenalezne druhý oddělovač, tak vrať aspoň text před prvním oddělovačem s kombinací funkce Když. Podmínková logika je nastavená jako pokud se nalezne hodnota #N/A z funkce TextPřed pomocí funkce Je.Nedef, tak se má zkusit nalézt první oddělovač, pokud ani ten se nenalezne, vrať text „Nenalezeno“. Pokud se ale najde a ve funkci Je.Nedef je tak false, bude vrácen text před druhým oddělovačem podtržítka.
=KDYŽ(JE.NEDEF(TEXTPŘED(A2;“_“;2));TEXTPŘED(A2;“_“;1;;;“Nenalezeno“);TEXTPŘED(A2;“_“;2))Související funkce
Sekce “Související funkce”
© 2026 Excelland